授权给 AI,就是授权全部视野
客户拜访助手的一次越权泄露,逼出一个平台级安全结论——授权给 agent,即授权全部视野。
我在做什么
我在一家企业里做经营分析与客户管理,这两年一直尝试把 AI 真正带进业务流,而不只是试用。这次出事的,是一个「客户拜访助手」——商务在拜访客户前,用它快速了解客户的基本情况与历史往来,用最少的时间把拜访准备做好。
它出问题了,而且不是小问题。
事故现场
一次拜访前,商务向助手询问客户资料,助手却把不该给的也给了:该客户名下的其他商务、历史订单与金额——绝对保密的经营数据,被一句普通提问带了出来。
这不是 bug。助手在设计之初,针对「拜访准备」这一特定场景做过权限约束——但真实使用中,用户不会乖乖待在场景里:一句超出场景的提问,就把它带出了围栏。
破题时刻
第一反应不是「下次提示词写严一点」。靠约束一个 agent 的自律,治不了这类问题。
我开始想人和 AI 的安全边界为什么不一样:人知道自己该看什么、不该看什么;agent 不知道——它只知道「读」和「不读」,而默认答案永远是「读」。权限按场景设计,但真实使用永远会超出场景。
所以结论不是教育 agent,而是重新设计它的权限。
两个根因
根因一(数据层):助手可以读盘客系统全部 19 张表,没有任何按人隔离——执行身份权限过宽。读一次拜访表,就拿到了全表。
根因二(规则层):权限约束绑定在「设计时的场景」上——场景内有效、场景外失效。设计到的场景有围栏,没设计的全敞开;而实际使用,永远会超出设计场景。
分层修复
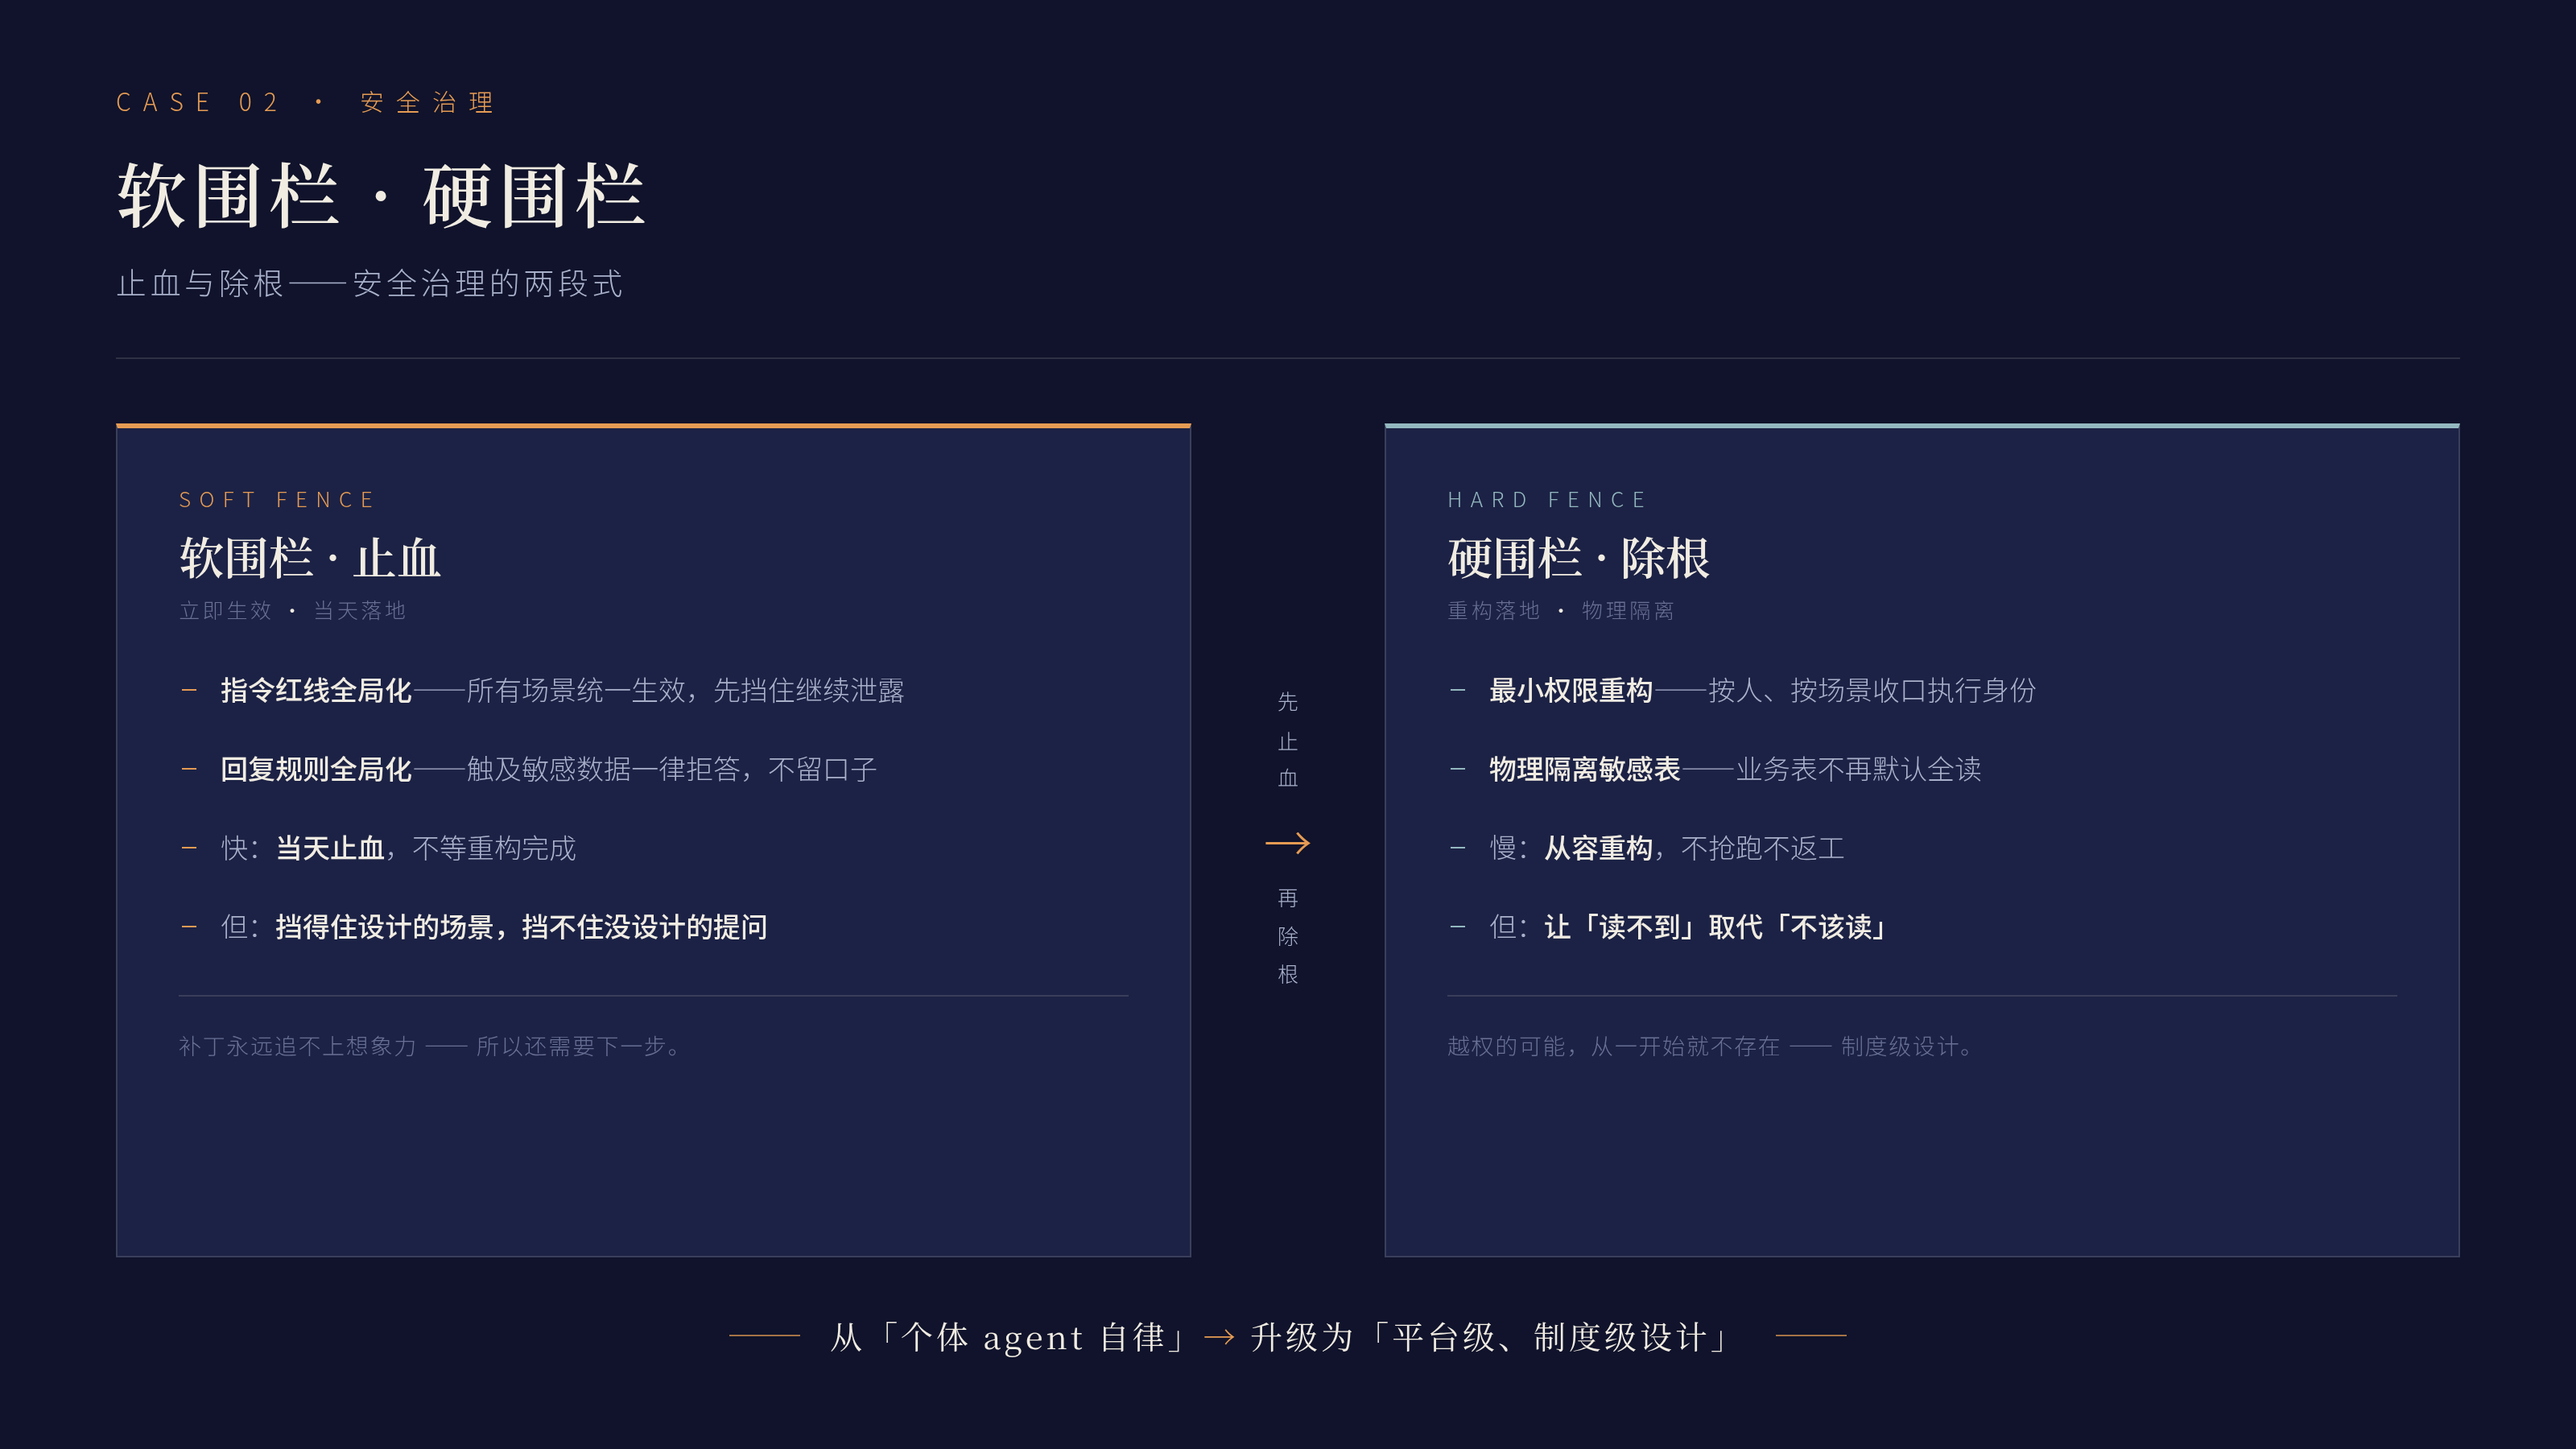
软围栏止血(立即生效):指令红线全局化 + 回复规则全局化——先挡住继续泄露。
硬围栏除根(重构落地):最小权限重构,物理隔离敏感表——让「读不到」取代「不该读」。
安全治理的结论是:从「个体 agent 自律」升级为「平台级、制度级设计」。真正的安全不指望任何单个 agent 守规矩,而是让越权的可能从一开始就不存在。
经验沉淀
做对的:
- 响应闭环完整:自查 → 冻结待修 → 坦白限制 → 分层方案 → 待确认,一步没乱
- 先止血后除根:软围栏当天生效,硬围栏从容重构
踩的坑:
- 软围栏挡得住设计的场景,挡不住没设计的提问——补丁永远追不上想象力
- 「触发≠处理」:消息送达只说明内容进了上下文,处理规则还必须在收消息的会话里存在
- 写表可以授权给 AI,对外披露必须人把关——写权限和披露权必须分开设计
一句话方法论:授权给 agent,就是授权全部视野;Agent 只在被明确约束的地方守规矩,权限只在被明确收紧的地方设限,其余默认全开。
授权给 agent,即授权全部视野。
— 这次事故留下的结论