AI 成本的田野实测:容错率决定付费意愿
十年报告制作中,AI 消耗成本首次成为主要矛盾——把「额度困局」做成一场田野实测。
我在做什么
我在一家媒体机构里做数据与 AI 落地。最近几个月,我在做两件事:把十年内容资产结构化,再让 AI 基于它产出报告和写作素材。
过去遇到的瓶颈,几乎都是「能力不够」:模型不会、答得不对。但这次不一样——第一次,成本压过了能力:AI 消耗的额度,成了最大的卡点。我决定把这场额度困局,当成一次田野实测来做。
成本首次成为主要矛盾
做十年内容变迁报告时,token 消耗开始肉眼可见地侵蚀进度。更麻烦的是「成本盲区」:编队跑在平台的限免期里,测不出真实 token 成本——质量、成本、用时三个指标,缺了一角。
限免期会过去,账迟早要算。与其等到被账单吓到,不如提前把成本当成一等公民来测量。
连轴转被限流:可以主动,但不可以失控
建叙事素材库时,我让 AI 连轴转批量处理,结果触发了平台限流。改成 15 分钟一次的定时任务后,问题消失。
这成了我跨平台验证的一个共识:可以主动,但不可以失控——主动服务的节奏,要和平台的承受能力对齐。
工具矩阵:选型逻辑变了
跑下来的工具矩阵是「双工具」:身份隔离 + 批量专司。有意思的是,这两家的额度套餐都不能单独加购——要扩容,只能整个套餐升级。
于是选型逻辑悄悄变了:从「哪个模型能力强」,变成「额度可采购性 + 身份隔离」。平台之间的差异点,正在从模型能力,转向额度供给的灵活性。
省钱实测:两条路都走不通
我试了两条省钱路线:凌晨免费窗口——额度极其有限,白嫖失败;多账号轮换——实测下来,一个账号一上午就烧光了 7 天额度。
轮换还有一个隐藏代价:不同账号的标注口径会漂移。对冲法是固定一份「标注标准示例 + 反例」文档,每个账号开跑前先喂一遍。
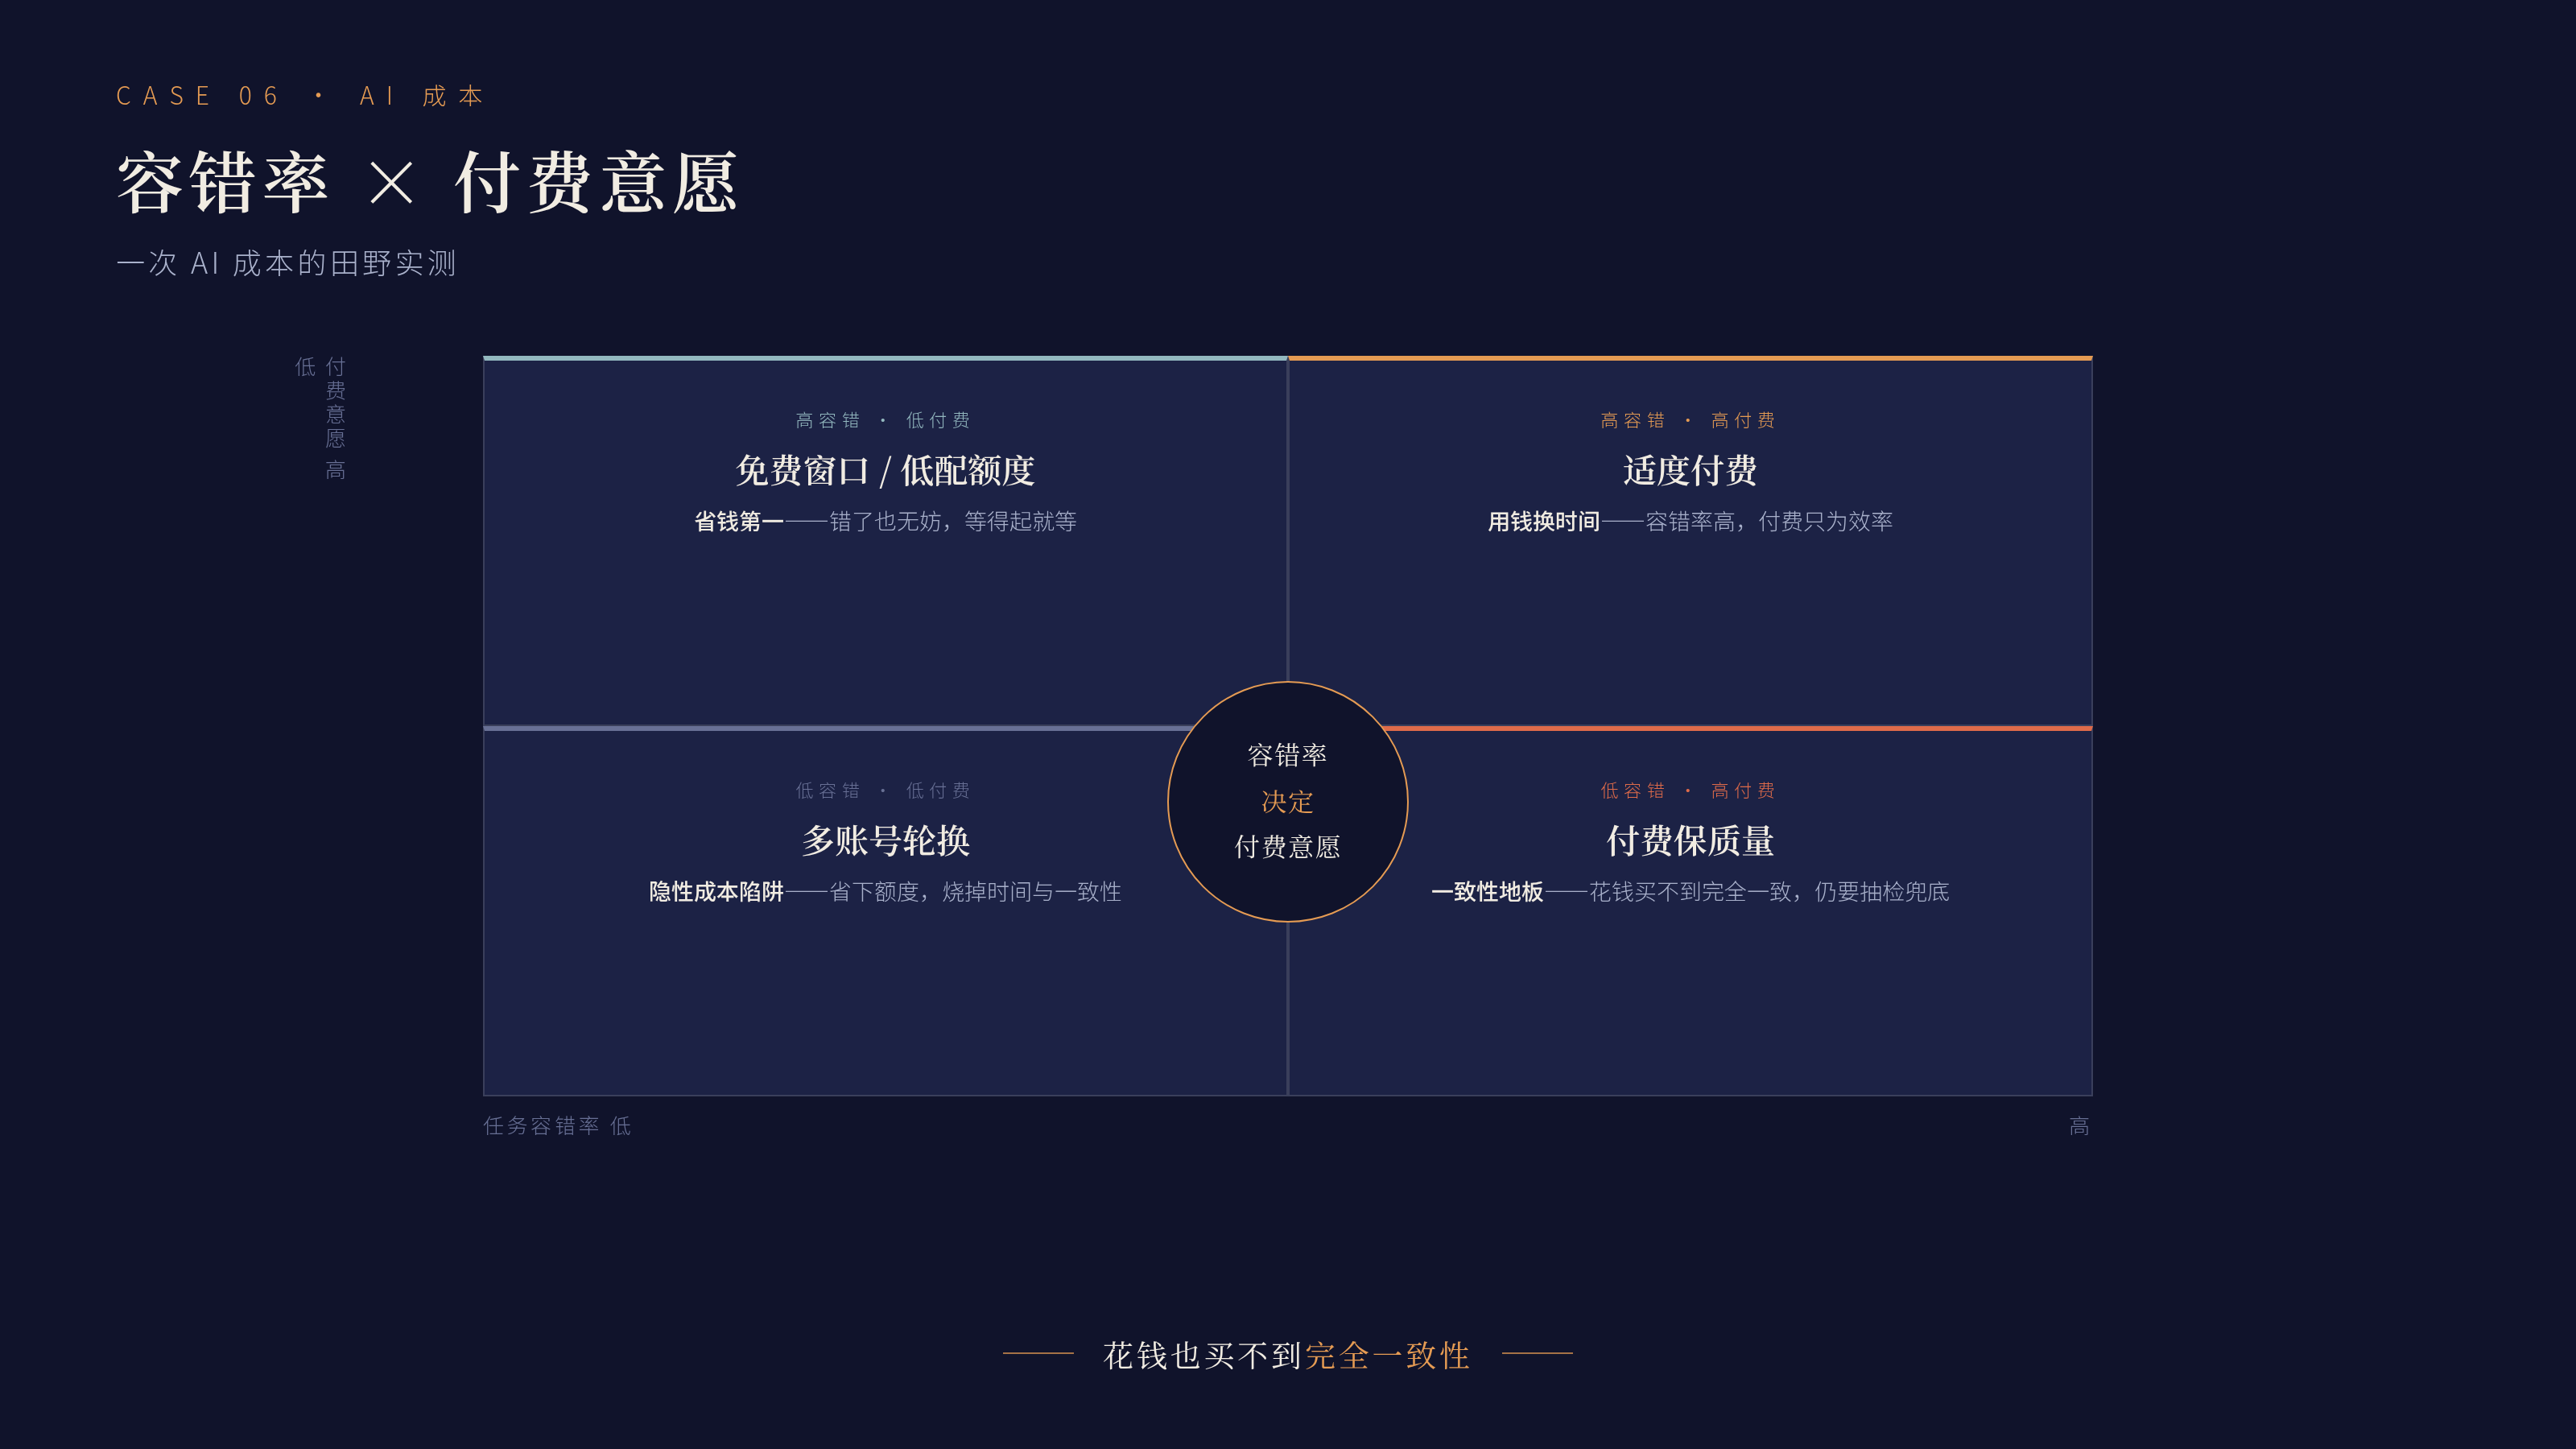
判据成形:容错率决定付费意愿
几次实测之后,判据终于清晰:容错率决定付费意愿。
- 任务容错率高(错了也无妨)→ 省钱策略可接受:等免费窗口、用低配额度
- 任务容错率低(错了就是事故)→ 多账号轮换的隐性成本(时间 + 质量风险)很可能超过付费本身
- 而无论怎么付费,都买不到完全一致性——模型的不确定性是这代模型的地板,凡 AI 建库,都要抽检兜底
结论是反直觉的:不是「穷」才用多账号,而是「容错率高」才适合省;容错率低的场景,付费反而是更便宜的选择。
经验沉淀
做对的:
- 把成本当成一等公民测量:限免期也要想办法摸清真实 token 成本
- 节奏对齐:15 分钟定时代替连轴转,「可以主动,但不可以失控」
- 选型逻辑升级:额度可采购性 + 身份隔离,和模型能力同等重要
- 口径漂移对冲:标准示例 + 反例文档,每个账号开跑先喂
踩的坑:
- 连轴转触发限流:主动不等于失控,节奏要可被平台承受
- 凌晨免费窗口白嫖失败:免费额度的量级,撑不起真实生产
- 多账号轮换烧额度还烧一致性:省钱可能省出事故
一句话方法论:容错率决定付费意愿;花钱也买不到完全一致性——凡 AI 建库,都要抽检兜底。
花钱也买不到完全一致性。
— 这场田野实测留下的结论