给访谈者做画像:从播客逐字稿里,看见访谈者自己看不见的风格
访谈准备大多靠经验、靠感觉——直到我用数据看见了一位访谈者自己看不见的风格。
我在做什么
我供职于一家媒体机构,日常做经营分析与 AI 落地。但我的研究对象不只是业务数据——还有内容生产本身:访谈、稿件、编辑判断。这个案例讲的,是我尝试用数据「看懂一位访谈者」的过程:从播客逐字稿出发,最后长出一套访谈分析的新方法。
起点:一场对谈,两个发现
一开始的想法很简单:访谈准备大多靠经验、靠感觉,能不能用数据看清楚一位访谈者到底是怎么提问的?
我拿两位知名文化人物的一场公开对谈做了第一次验证——2.5 小时的逐字稿,统计每个提问的追问次数。结果出乎意料地清晰:追问次数直接暴露了访谈者的兴趣所在,也暴露了被访者的专长领域。哪些话题上他会不断追问、哪些话题浅尝辄止,一数便知。
第一场验证给了我信心:访谈风格不是玄学,是可以被量化、被看见的。
系统化:13 场播客,三条规律
验证通过后,我把分析铺开到一位资深访谈者的 13 场播客(约 13.4 小时、覆盖 8 种被访者类型),做了系统性画像。三条规律浮出水面:
- 挑战密度与被访者的理性程度正相关:面对理性程度高的被访者,访谈者会更尖锐地追问;面对偏感性表达的,几乎零挑战。有人每小时被挑战 8 次以上,有人一场下来一次都没有。
- 共情密度与被访者的脆弱程度正相关:被访者越敞开、越脆弱,访谈者的共情回应越密集——最高的每小时出现 56 次共情表达。
- 话语权与被访者的接话能力负相关:被访者越能接话,访谈者说的越少;有的被访者话语权只有 16.7%,有的能到 33.9%。
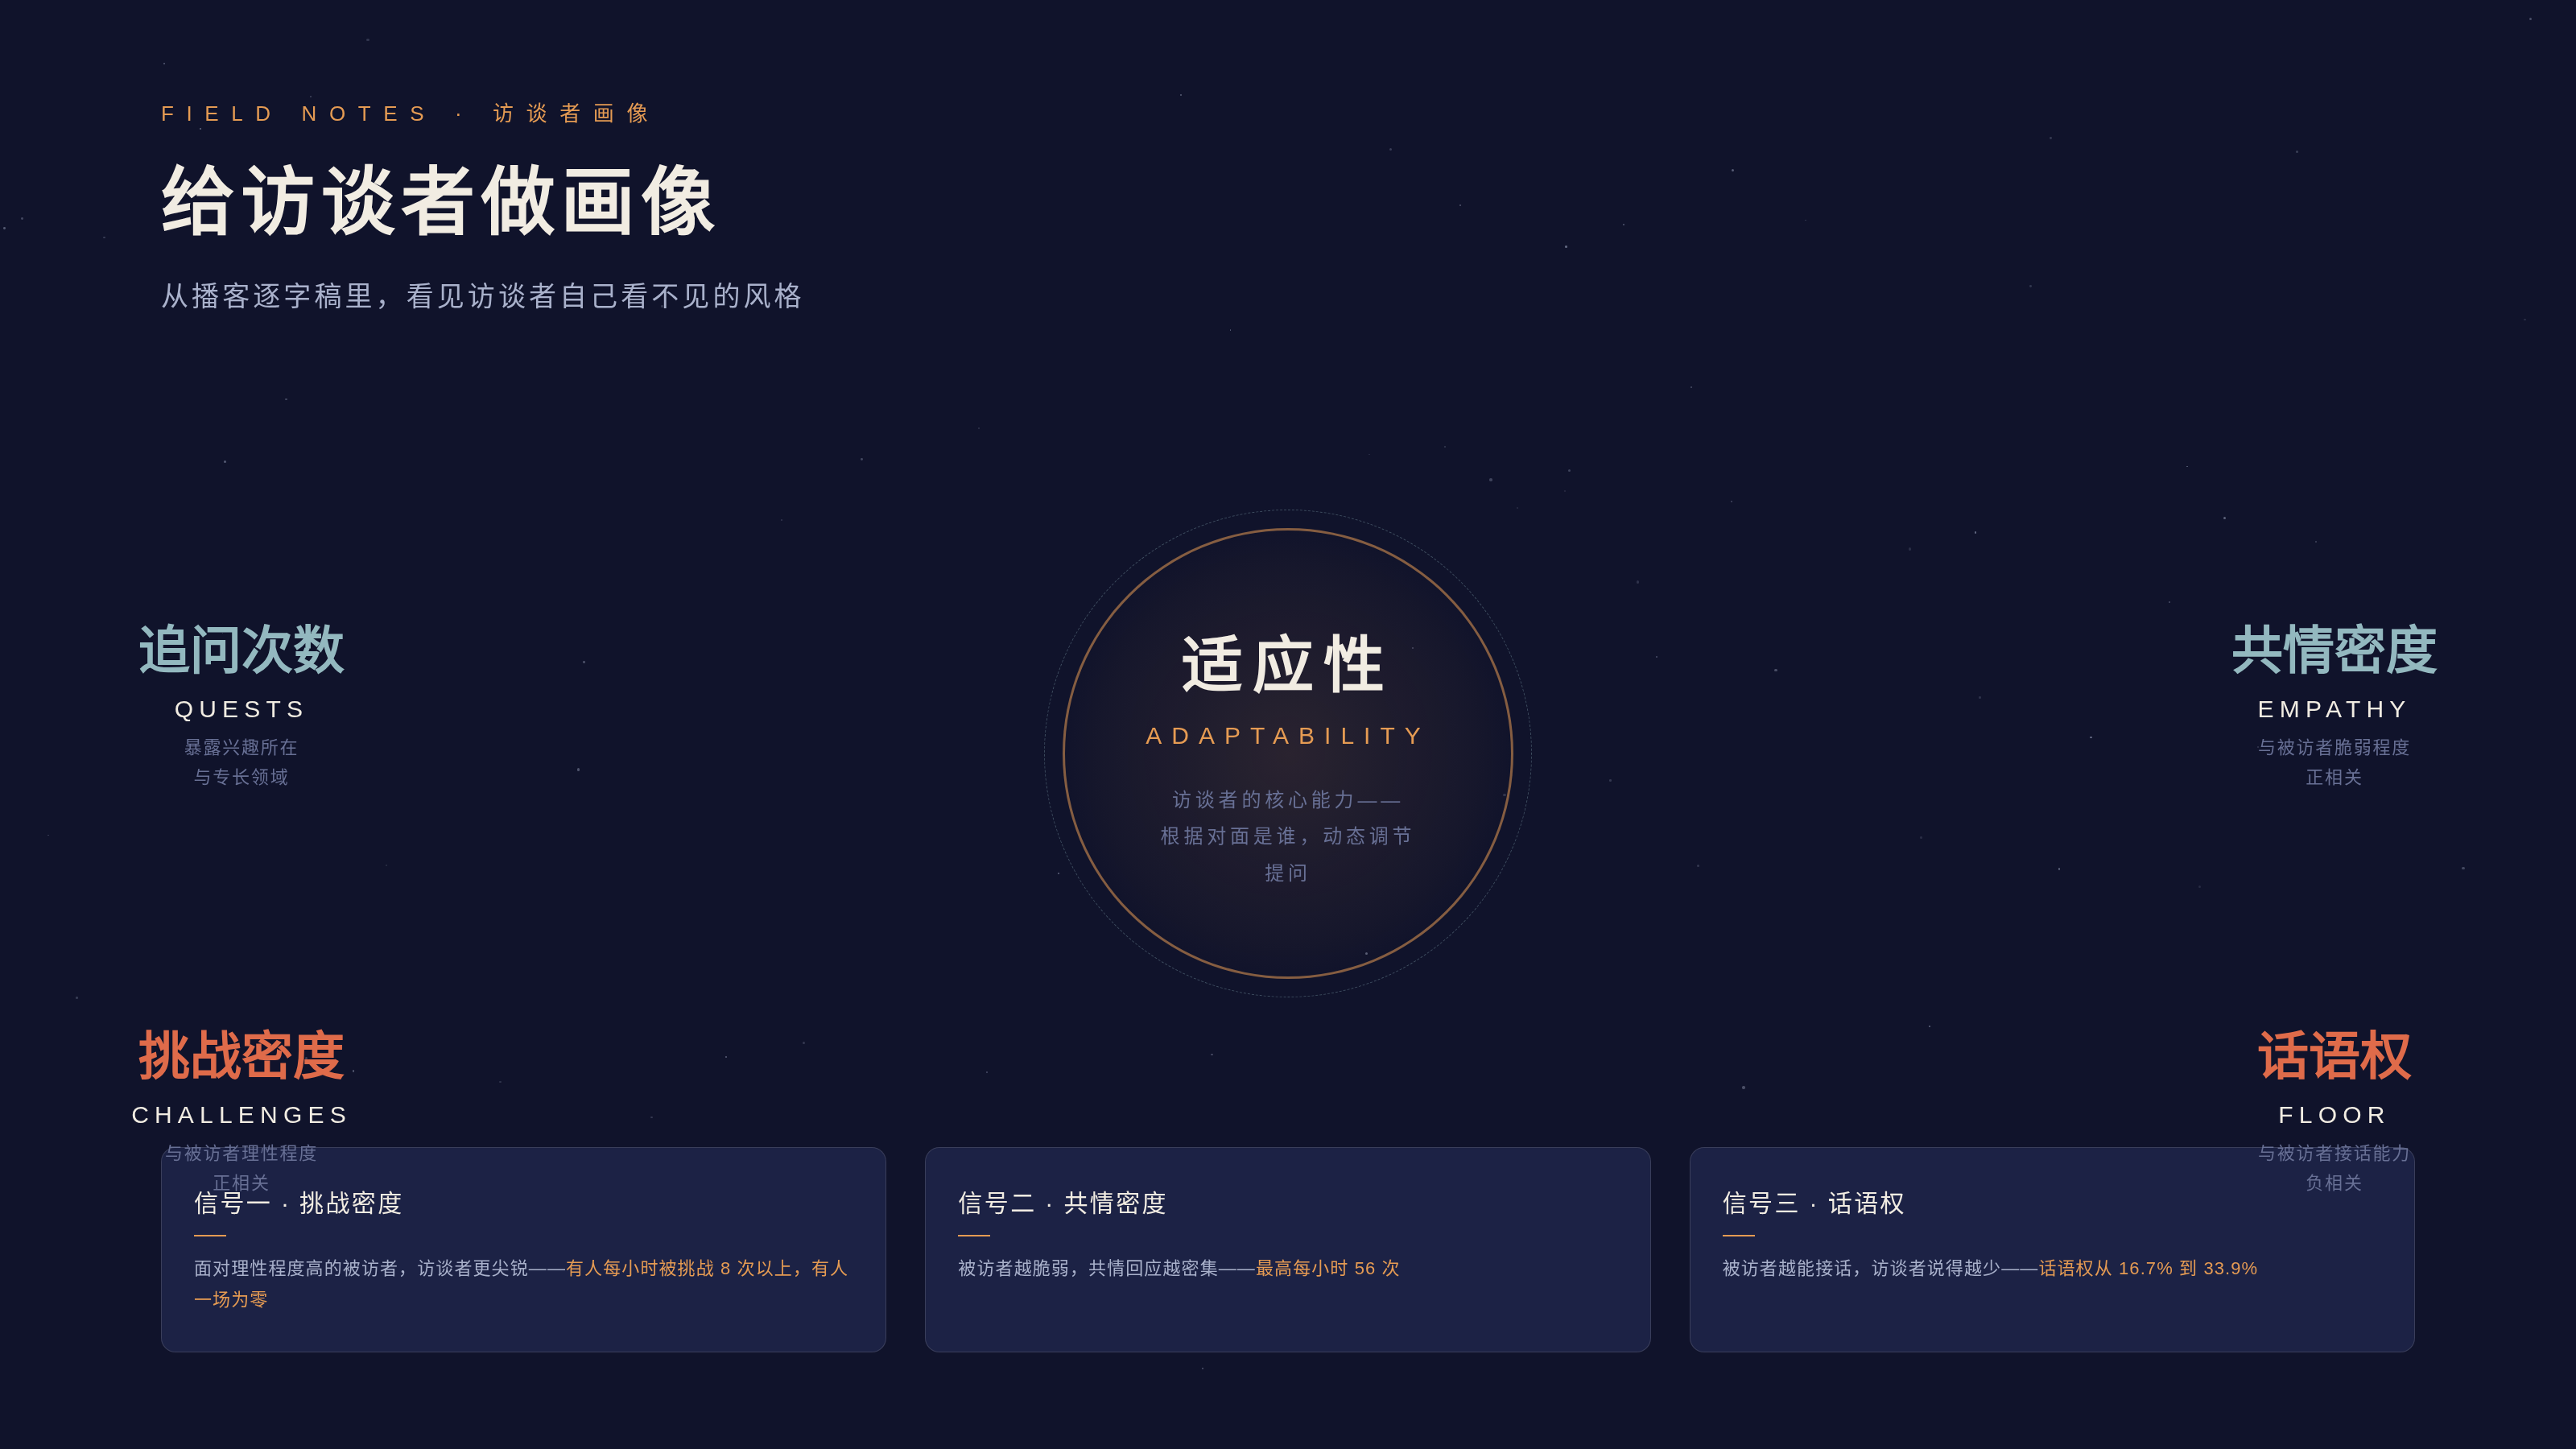
三条规律指向同一个结论:访谈者的核心能力不是共情、也不是追问,而是「适应性」——根据对面这个人是谁,动态调节自己的提问方式。而这种能力是直觉,不是技巧。
下游:画像库的两个应用
画像建完之后,价值开始往下游延伸:
- 内部访谈者画像库——未来有访谈任务时,按访谈者类型匹配推荐最合适的人;
- 访谈提纲助手——基于画像生成更有针对性的提问方向。
技术性的分析已经跑通,我以为这件事快做完了。
被点醒:一句「缺新闻性」
把画像交付给该访谈者时,她给了一句让我重新审视整件事的反馈:「没抓住新闻性。」
技术分析再准,回答的也只是「这场访谈做得好不好」;但真正的问题其实是「为什么这个人重要」——这个人为什么值得被访谈、值得被报道、值得读者花时间。我盯着技术指标,差点错过了「道」。
升级:从技术,到「道」
于是我把访谈分析从单轨升级为双轨:
- 技术性:回答「做得好不好」——追问密度、共情密度、话语权分布;
- 道:回答「为什么这个人重要」——具体化为两个可操作指标:话题与故事母题的关联、传播金句的捕捉。
双轨不是平行,而是分层:只盯技术,找到的是好匠人;「道」打通,才能挑出撑得起头版的人。
机制化:编辑 agent 与多 agent 小队
「道」不能只靠我一个人的判断,我开始把它机制化。
先做编辑痕迹分析——把资深编辑改稿的痕迹喂给 AI 学习,拿到 75% 的准确度基线;再把写作能力改造成专家编辑 agent,跑通了「文档内划线评论」——批注粒度从整篇降到了句子级。
最后收敛到多 agent 编辑小队的设计:让事实、结构、金句三个视角独立存在,各自批注。这里有一个反直觉的发现:多 agent 的价值不在更准,而在更可见——单 agent 多视角会天然「合并」,把张力压平成一个折中判断;多 agent 强制让不同意见独立存在,编辑像看不同编辑的意见一样,自己取舍。
真正的编辑 agent 学的不该是「标准答案」,而是「这种判断的张力点在哪里」。AI 负责把备选项与冲突呈现到最可见,拍板永远留给编辑。
经验沉淀
做对的:
- 访谈风格可以被量化:追问次数、挑战密度、共情密度、话语权,四个指标足够看见一个访谈者;
- 「道」可以具象化:母题关联 + 金句捕捉,让「新闻性」从感觉变成可检查的指标;
- 判断永远留给人:AI 做备选项和冲突呈现,不替编辑下结论。
踩的坑:
- 指标边界要看场景:追问次数在一问一答的对谈里有效,在深度对谈里会失真——统计出的差异可能是节目形态差异,不是兴趣差异;
- 把「技术性」当成全部:差点错过「为什么这个人重要」这个更根本的问题;
- 单 agent 多视角的陷阱:视角多了反而倾向于合并、压平张力。
一句话方法论:让 AI 学「张力」,而不是学「答案」——真正有效的 agent 是意识到张力的人,不是背会标准答案的人。
访谈者的核心能力是适应性,不是共情,也不是追问——它是直觉,不是技巧。
— 这次访谈分析留下的两句话