把 500 篇案例和 400 份文件,变成 AI 能读的数据
两件「一直被工作量吓退」的事,怎么被 AI 一次跑完——从逐个喂,到批量就能跑。
我在做什么
我供职于一家媒体机构,日常做经营分析与 AI 落地。这个案例讲的是两件「一直被工作量吓退」的事,怎么被 AI 一次跑完的:一是把过去几百篇客户合作案例变成结构化数据,二是把几百份混杂格式的客户策划需求文件变成可检索的文本。它们最后合并成两个数据库,成为后续 AI 应用的底座。
困局:一直想做,一直被吓退
客户合作案例这件事,团队想做很久了。它们是谈客户时最有力的证明——「我们为什么值得被选」。但材料散在公众号文章、视频号、各种历史文档里,要靠人工一篇篇读、一篇篇总结成结构化字段,工作量大到没人愿意开头;早年的 AI 效果也差,读长文总结出来都是空话。
一句话:不是不想做,是「需要人逐个喂」这件事本身把项目杀死了。
破题:把「逐个喂」变成「批量跑」
转机来自一次工具尝试:我拿到一批历史合作文章链接,交给批量分析工具,按「为什么选我们 / 客户需求 / 我们提供什么」三问框架跑。第一次跑通之后,我意识到这件事的形态变了——
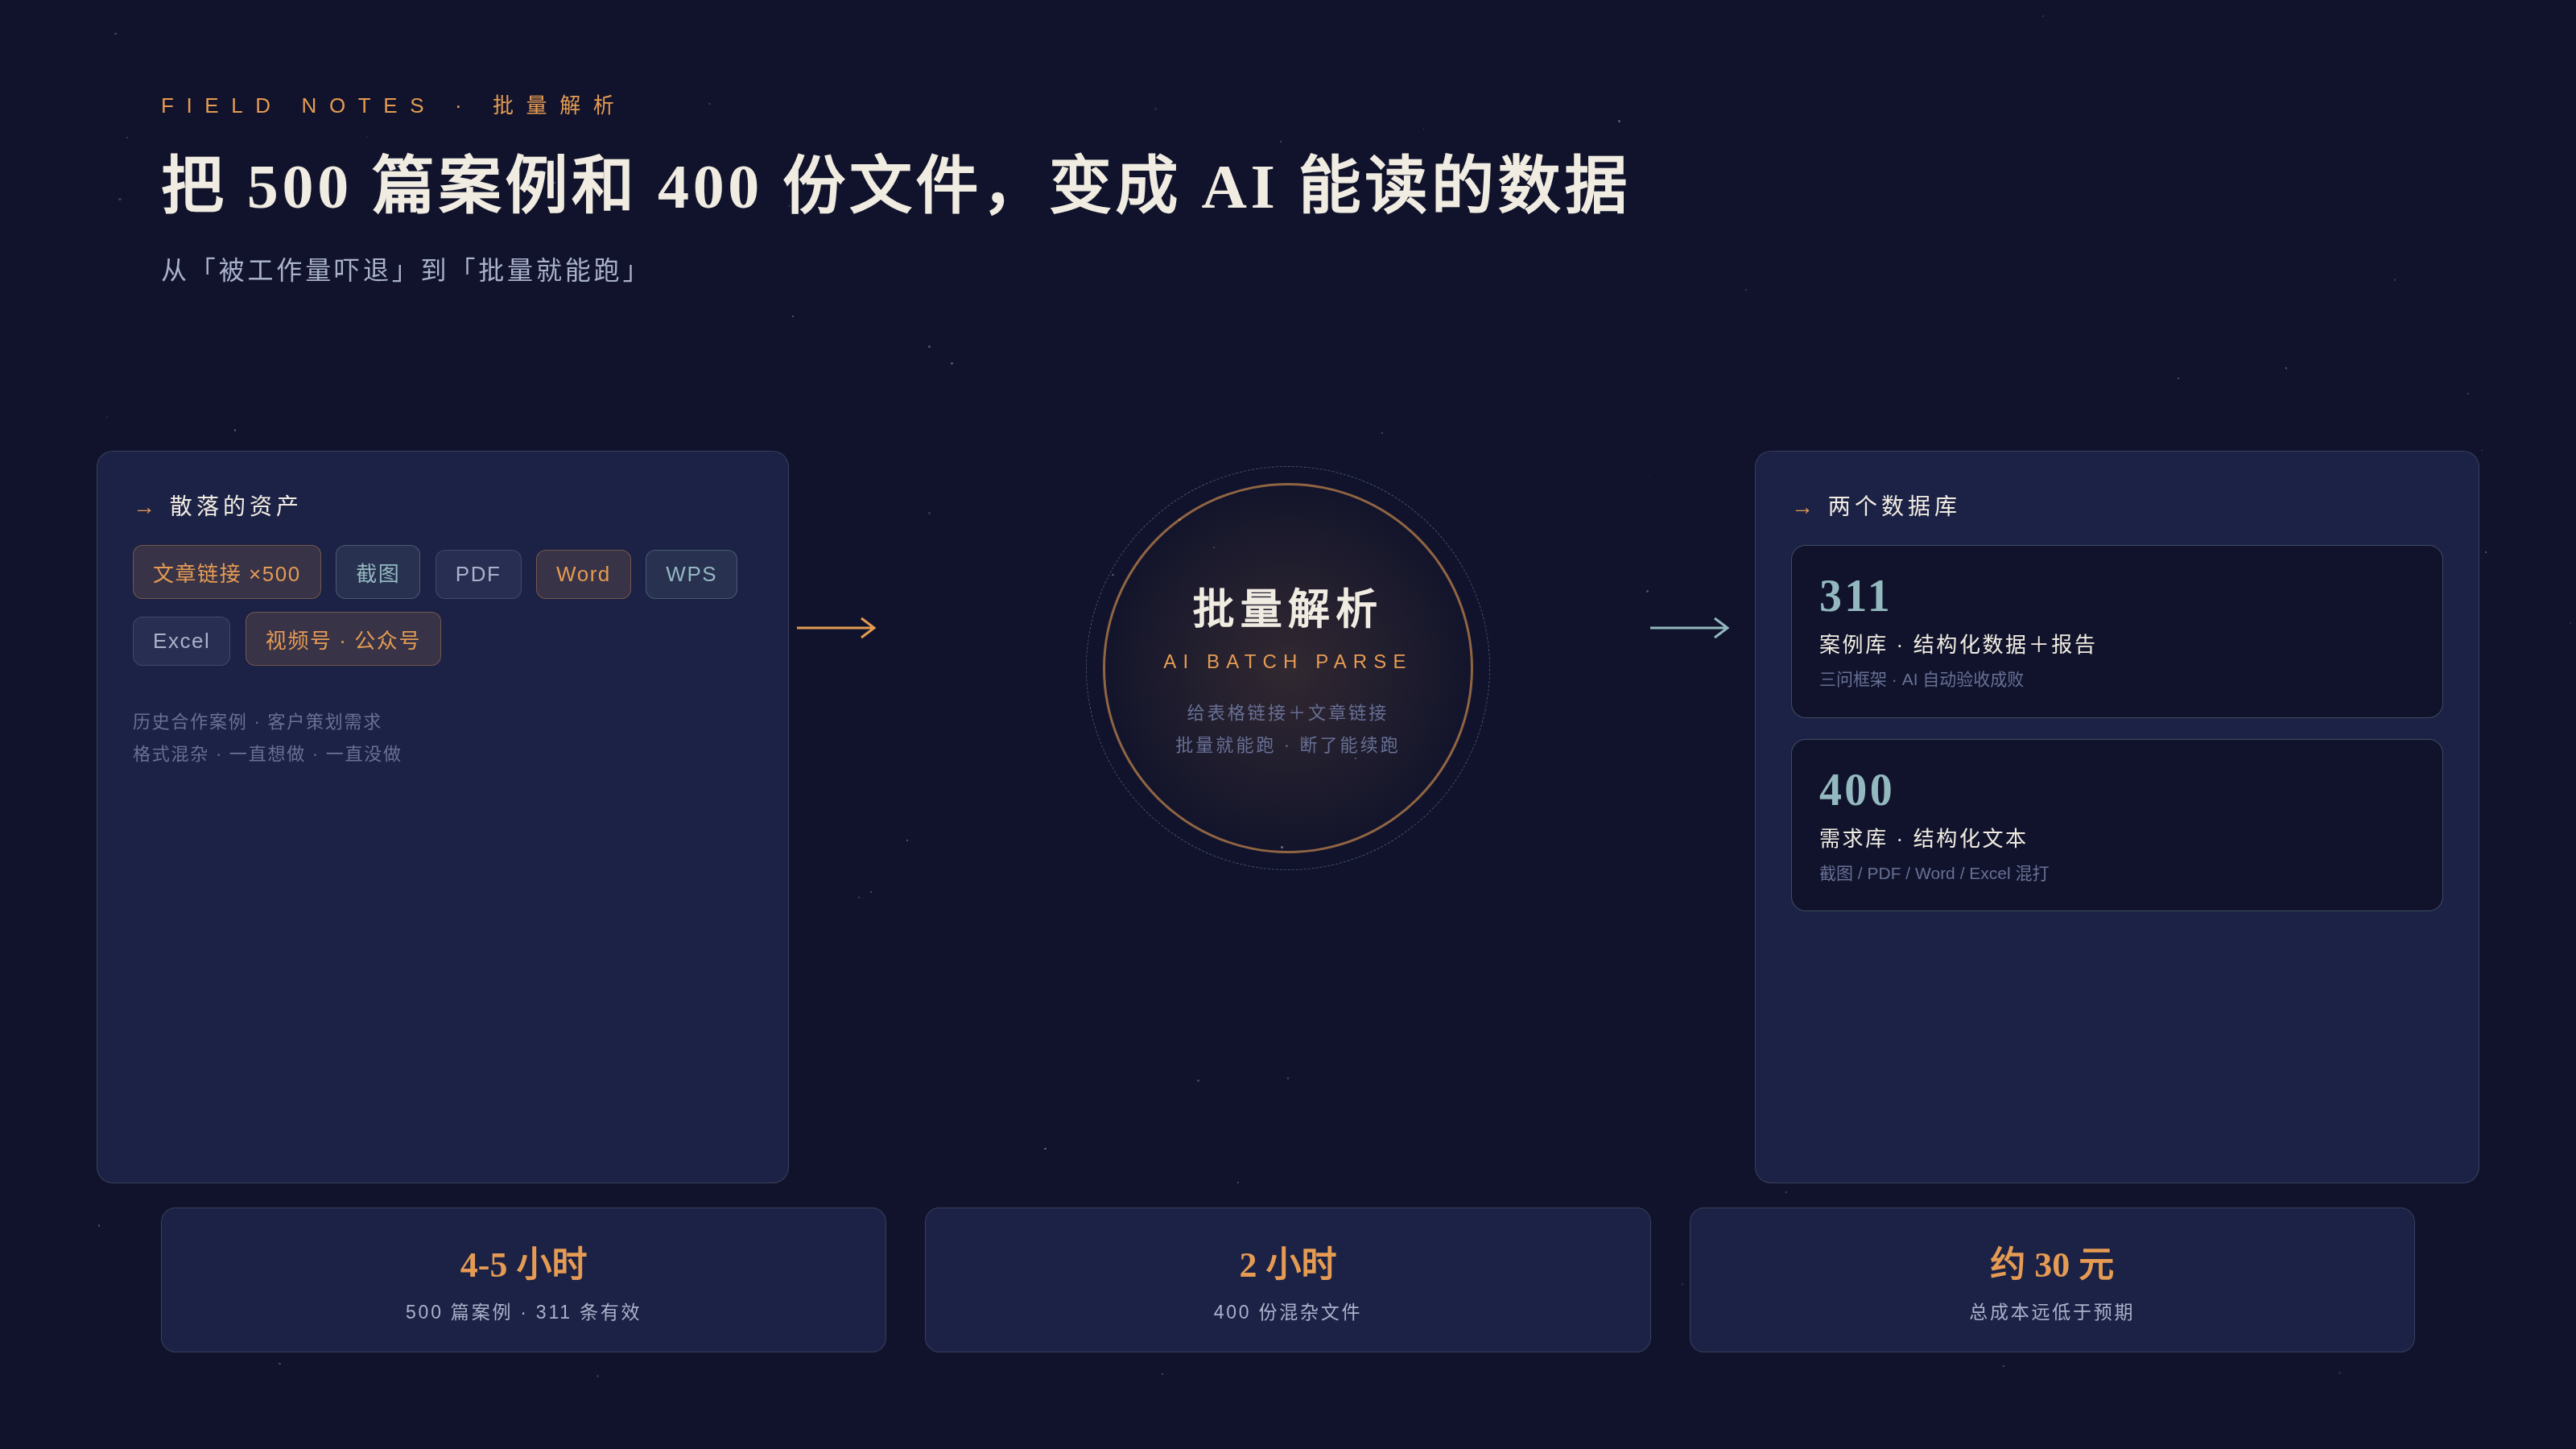
过去要一个一个喂,现在给表格链接+文章链接,批量就能跑。
落地一:500 篇案例,4-5 小时变成 311 条结构化数据
第一批规模是约 500 个历史合作文章链接。AI 按三问框架批量分析,产出 311 条结构化数据 + 311 份文档版分析报告,大约 4-5 小时跑完。剩余约 200 条是原始链接失效(视频号迁移、公众号改版)——不是分析失败,是源头没了。
几个超出预期的细节:
- 报告结构稳定:311 份报告的分析框架保持一致,质量没有随着批量放大而稀释;
- 断了还能续跑:中途额度耗尽、切模型报错,任务居然不丢进度,恢复后继续跑完;
- AI 自己标成败:它自动做「原始链接 vs 分析结果」对比,给每条结果标上成功或失败——验收都自动化了。
落地二:400 份混杂文件,2 小时、约 30 元
第二件事是客户策划需求:约 400 份文件,截图、PDF、Word、WPS、Excel 什么格式都有,目标是批量解析成结构化文本。用多维表格的 AI 能力跑,约 2 小时、约 30 元完成——成本和耗时都远低于预期。
踩的坑:模型「罢工」,却没有提示
这次也踩了一个真坑:AI 给出的预估时间不准,实际模型已经停止工作了,界面却还显示「正在跑」——我一度以为还在正常执行。后来跟产品方确认,是多维表格 AI 存在「罢工」现象且没有明确提示,需要对模型说「继续」才能恢复。
这是产品级体验问题,不是我的配置问题。但它给我一个提醒:跑批处理,进度显示会骗人;真正要紧的是能发现「停滞」——而不是相信「正在跑」。
下一步:两个库合起来,喂给销售
两个数据库(311 条案例 + 400 份需求)建完后,「非常贴合业务」。下一步计划基于两个库一起做销售 Agent:销售输入客户需求 → Agent 同时查需求库和案例库 → 自动出提案。库的价值不在建起来,在被消费。
经验沉淀
做对的:
- 换工具形态,不硬扛工作量:把「逐个喂」改成「批量跑」,被工作量吓退的事才可能开始;
- 让 AI 自己验收:原始链接 vs 结果对比、自动标成败,把验收也自动化;
- 两个库合并规划:案例库回答「凭什么选我们」,需求库回答「他们想要什么」,合起来才是提案的原料。
踩的坑:
- 别信「正在跑」:批量任务的进度显示可能失效,要设计发现停滞的机制;
- 原始链接会过期:视频号迁移、公众号改版会让存量链接失效——能跑通 311/500 已经是好结果;
- 预估时间不可靠:AI 给的时间估算仅供参考,别拿它当排期依据。
一句话方法论:历史资产结构化的关键不是「AI 能不能读」,而是「人愿不愿意开始」——把单次成本压到可接受,存量才有机会被唤醒。
过去要一个一个喂,现在给表格链接+文章链接,批量就能跑。
库的价值不在建起来,在被消费。